
티스토리 뷰
Paper/TTS
[Paper 리뷰] EmoTra-TTS: Smooth Intra-Utterance Emotion Transitions for Speech Synthesis
feVeRin 2026. 9. 16.반응형
EmoTra-TTS: Smooth Intra-Utterance Emotion Transitions for Speech Synthesis
- 기존의 emotional Text-to-Speech는 emotion의 temporal nature와 misalign 함
- EmoTra-TTS
- Multi-pass flow blending pipeline을 활용해 frame-aligned transition audio를 반영
- Dual-stage Valence-Arousal-Dominance conditioning을 통해 LLM과 Flow Decoder를 guide
- Direction-magnitude decoupled injection을 사용하여 content degradation을 방지
- 논문 (EMNLP 2026) : Paper Link
1. Introduction
- Affective state는 continuously fluctuate 함
- BUT, EmoSphere-TTS, WeSCon과 같은 기존의 emotional Text-to-Speech (TTS) model은 utterance 당 하나의 categorical label을 assign 함
- 이로 인해 rise, transition, decay와 같은 continuous temporal emotion dynamics를 modeling 하기 어려움 - Large Language Model (LLM)-based TTS system 역시 targeted emotion을 효과적으로 반영하지 못함
- BUT, EmoSphere-TTS, WeSCon과 같은 기존의 emotional Text-to-Speech (TTS) model은 utterance 당 하나의 categorical label을 assign 함
-> 그래서 continuous emotion transition을 modeling 할 수 있는 EmoTra-TTS를 제안
- EmoTra-TTS
- Multi-pass Flow Blending pipeline에 기반한 emotion transition data generation을 통해 data scarcity 문제를 해결
- Dual-stage Valence-Arousal-Dominance (VAD) conditioning을 통해 temporally aligned emotion signal을 생성
- Direction-Magnitude Decoupled Injection을 도입하여 content-expressiveness trade-off를 완화
< Overall of EmoTra-TTS >
- Multi-pass flow blending, Dual-stage VAD conditioning, Direction-magnitude injection을 활용한 expressive TTS model
- 결과적으로 기존보다 우수한 성능을 달성
2. Method
- 논문은 minimal temporal unit을 initial emotion $v_{init}$에서 resultant emotion $v_{res}$로의 transition으로 modeling 하여 emotion의 non-trivial dynamic pattern을 represent 하는 것을 목표로 함
- Problem Formulation
- Text $\mathcal{T}$, initial emotion $v_{init}=(V_{init}, A_{init}, D_{init})\in[0,1]^{3}$, resultant emotion $v_{res}\in[0,1]^{3}$에 대해, 논문은 utterance duration 동안 $v_{init}$에서 $v_{res}$로의 emotion transition이 나타나는 speech를 synthesize 함
- 즉, static endpoint가 아닌 emotional episode의 temporal transition을 modeling 해야 함
- 이를 위해 논문은 Valence-Arousal-Dominance (VAD) dimensional model을 도입함:
- Continuous space에서 specific point로 discrete emotion category를 subsum 할 수 있음
- Smooth transition을 위한 interpolation을 지원하므로 gradual emotion shift를 반영할 수 있음
- Well-established acoustic correlate를 가지므로 meaningful acoustic variation과 대응할 수 있음
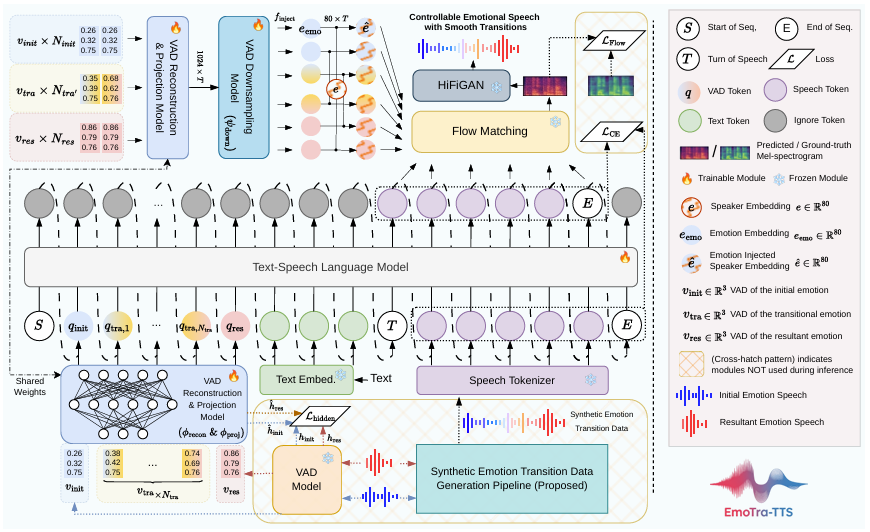
- Synthetic Emotion Transition Data
- 기존의 emotional speech corpora는 single emotion label로 annotate 되어 있으므로, 논문은 pre-trained zero-shot TTS system을 활용하여 synthetic emotion transition data를 추가적으로 생성함
- Text, emotion pair $(\text{initial}, \text{resultant})$가 주어졌을 때 Multi-Pass Flow Blending pipeline은 다음과 같음:
- Shared Token Generation
- LLM은 initial emotion에 condition 되어 single speech token sequence $s_{init}=[s_{1},...,s_{M}]$을 생성함
- 해당 sequence는 prosodic structure를 encoding 하고 모든 subsequent flow pass에서 share 되어 frame-level temporal alignment를 보장함 - Multi-Pass Flow Decoding
- 3개의 independent flow pass를 통해 emotion-specific mel-spectrogram을 생성함:
(Eq. 1) $\text{mel}_{init}=\text{Flow}(s_{init},e_{init},c_{init})$
(Eq. 2) $\text{mel}_{tra}=\text{Flow}(s_{init},e_{res},c_{init})$
(Eq. 3) $\text{mel}_{res}=\text{Flow}(s_{init},e_{res},c_{res})$
- $e$ : speaker embedding, $c$ : prompt condition
- Intermediate $\text{mel}_{tra}$는 initial emotion의 masked mel-spectrogram context와 resultant emotion의 speaker embedding을 기반으로 두 emotional state 간의 transition bridge를 구성함 - Sigmoid Crossfade Blending
- 3개의 mel-spectrogram은 Sigmoid Crossfade를 통해 blend 됨:
(Eq. 4) $\sigma(t)=\frac{1}{1+e^{-\kappa (t-t_{c})}}$
- Steepness $\kappa$, center $t_{c}$는 edge에서 near-binary blending을 제공하고 center에서 smooth crossfade를 제공하여 linear blending/hard concatenation의 audible artifact를 방지함 - Quality Filtering
- 최종적으로 Whisper Automatic Speech Recognition (ASR) model을 사용해 integrity를 verify 함
- 이때 CER threshold $\tau_{CER}$, WER threshold $\tau_{WER}$을 exceed 하는 sample은 discard 됨
- Shared Token Generation
- 추가적으로 initial, resultant emotion에 대한 VAD value는 pre-trained Wav2Vec2-based Speech Emotion Recognition model로 reference speech를 annotate 하여 얻어짐
- Text, emotion pair $(\text{initial}, \text{resultant})$가 주어졌을 때 Multi-Pass Flow Blending pipeline은 다음과 같음:
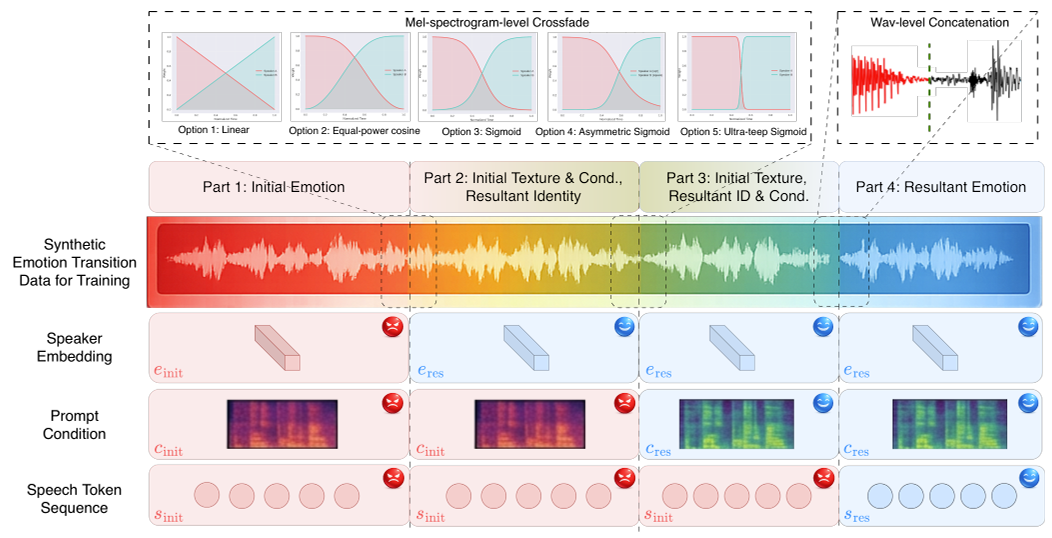
- LLM with Temporal VAD Tokens
- VAD Projection
- Projection network $\phi_{proj}:\mathbb{R}^{3}\rightarrow \mathbb{R}^{d_{LLM}}$은 VAD vector를 LLM embedding space로 mapping 함:
(Eq. 5) $\phi_{proj}(v)=W_{2}\cdot \text{ReLU}(\text{LN}(W_{1}v +b_{1}))+b_{2}$
- $W_{1}\in\mathbb{R}^{d_{h}\times 3},W_{2}\in\mathbb{R}^{d_{LLM}\times d_{h}}$, $\text{LN}$ : LayerNorm - Intermediate normalization은 $3$에서 $d_{LLM}$으로의 dimensionality expansion을 stabilize 함
- Projection network $\phi_{proj}:\mathbb{R}^{3}\rightarrow \mathbb{R}^{d_{LLM}}$은 VAD vector를 LLM embedding space로 mapping 함:
- Temporal Token Design
- Single VAD embedding은 static global label만 제공하고, endpoint $v_{init}, v_{res}$에는 transition trajectory가 남아있음
- 따라서 논문은 해당 line segment를 따라 $N_{tra}$ intermediate point를 uniformly sampling 하여 continuous VAD transition을 discrete token sequence로 encoding 함:
(Eq. 6) $q_{tra,k}=\phi_{proj}\left( (1-\alpha_{k})v_{init}+\alpha_{k}v_{res}\right),\,\,\, \alpha_{k}=\frac{k}{N_{tra}+1}$
- $k=1,2,...,N_{tra}$ - 결과적으로 endpoint token $q_{init}, q_{res}$를 포함하여 $N_{tra}+2$개의 VAD token이 text token에 prepend 됨
- Training Objective
- Input sequence $\text{[SOS]}[q_{init}, q_{tra,1}, ..., q_{tra,N_{tra}}, q_{res}]\text{[text][task][speech][EOS]}$에 대해, loss는:
(Eq. 7) $\mathcal{L}_{LLM}=\mathcal{L}_{CE}+\lambda\cdot \mathcal{L}_{hidden}$
- $\mathcal{L}_{CE}$ : speech token의 Cross-Entropy loss - 여기서 hidden-state reconstruction loss $\mathcal{L}_{hidden}$은 preceptual grounding을 제공함
- 해당 loss가 없다면 $\phi_{proj}$는 VAD vector를 acoustically-meaningless 한 embedding region에 mapping 함:
(Eq. 8) $\hat{h}_{init}=\phi_{recon}(q_{init}),\,\,\, \hat{h}_{res}=\phi_{recon}(q_{res})$
(Eq. 9) $\mathcal{L}_{hidden}=\left|\left| \hat{h}_{init}-h_{init}\right|\right|_{1}+\left|\left| \hat{h}_{res}-h_{res}\right|\right|_{1}$
- $\phi_{recon} : \mathbb{R}^{d_{LLM}}\rightarrow \mathbb{R}^{d_{SER}}$ : perceputally meaningful prosodic/affective representation을 위해 choring VAD embedding인 Wav2Vec2 feature space로 mapping 됨
- Input sequence $\text{[SOS]}[q_{init}, q_{tra,1}, ..., q_{tra,N_{tra}}, q_{res}]\text{[text][task][speech][EOS]}$에 대해, loss는:
- Flow Decoder with Frame-Level Emotion Injection
- Emotion via Speaker Pathway
- Backbone flow decoder는 CosyVoice2를 따라 4-channel input $[x_{t},\mu,e,c]$를 사용함
- 각 channel은 $\in\mathbb{R}^{mel}$이고 $\mu$는 linguistic content, $e$는 speaker identity를 encode 함 - 특히 논문은 speaker channel을 통해 emotion을 inject 함
- Speaker identity, emotion은 content에 대해 same conditioning role을 share 함
- 기존 channel을 통한 additive injection은 adapter-based approach의 minimal intervention principle을 따라 architectural modification이 필요하지 않음:
(Eq. 10) $\hat{e}(t)=e+e_{emo}(t)$
- 이는 static 2D speaker tensor를 time-varying 3D tensor $\hat{e}\in\mathbb{R}^{B\times d_{mel}\times T}$로 extend 함
- Backbone flow decoder는 CosyVoice2를 따라 4-channel input $[x_{t},\mu,e,c]$를 사용함
- Frame-Level VAD Interpolation
- Frame-level VAD $v(t)$는 piece-wise linear interpolation을 통해 구성됨
- 즉, $t<r_{init}]\cdot T$일 때는 $\alpha(t)=0$, $\left[r_{init}\cdot T, (r_{init}+r_{tra})\cdot T\right)$에서는 linearly interpolate, 이후에는 $\alpha(t)=1$이 됨
- 이는 temporal structure를 반영하여 training supervision과 inference-time conditioning 간의 consistency를 보장함
- VAD Embedding Pipeline
- Emotion embedding은 cross-stage consistency를 위해 frozen LLM-stage module을 reuse 함:
(Eq. 11) $e_{emo}(t)=f_{inject}\left(\psi_{down}\left(\phi_{recon}\left( \phi_{proj}\left( v(t)\right)\right)\right)\right)$
- $phi_{proj},\phi_{recon}$은 freeze 되고 $\psi_{down} : \mathbb{R}^{d_{SER}}\rightarrow \mathbb{R}^{d_{mel}}$은 zero-initialized trainable MLP output layer에 해당함 - VAD module을 freeze/reuse 하면 동일한 VAD vector가 각 stage에서 동일한 intermediate representation을 생성하므로, learned perceptual grounding을 additional supervision 없이 preserve 할 수 있음
- Emotion embedding은 cross-stage consistency를 위해 frozen LLM-stage module을 reuse 함:
- Direction-Magnitude Decoupled Injection
- MLP conditioning vector는 두 semantically distinct factor (direction, magnitude)를 entangle 함
- 이때 unconstrained training이나 soft constraint를 사용하면 content degradation이 발생함 - 따라서 논문은 architectural constraint를 통해 hard separation을 enforce 함:
(Eq. 12) $f_{inject}(x)=\epsilon\cdot \text{LayerNorm}(x)$ - LayerNorm은 MLP output을 re-normalize 하여 emotion direction을 학습하는 동안 injection magnitude를 control 함
- Trainable affine parameter $(\gamma, \beta)$는 identity-initialize 되고, non-trainable scalar $\epsilon$은 injection strength를 independently control 함
- 추가적으로 zero-initialized output layer는 training start에서 $e_{emo}(t)=0$을 보장함
- 결과적으로 complete injection은:
(Eq. 13) $\hat{e}(t)=e+\epsilon \cdot \text{LN}\left(\psi_{down}\left(\phi_{recon}\left(\phi_{proj}\left(v(t)\right)\right)\right)\right)$
- 모든 decoder paramter는 freeze 되고, $\psi_{down}, \text{LayerNorm}$ affine parameter만 trainable 함
- MLP conditioning vector는 두 semantically distinct factor (direction, magnitude)를 entangle 함
- Flow Matching Training Objective
- Flow decoder는 Conditional Flow Matching (CFM) objective로 training 됨
- Target mel-spectrogram $x_{1}\in\mathbb{R}^{d_{mel}\times T}$, noise $z\sim \mathcal{N}(0,I)$, time $t\sim \mathcal{U}(0,1)$이 주어진다고 하자
- 그러면 $\sigma_{\min}=10^{-6}$에 대해 interpolate sample $x_{t}=\left(1-(1-\sigma_{\min})t\right)z+tx_{1}$과 ground-truth velocity $u=x_{1}-\left(1-\sigma_{\min}\right)z$를 구성할 수 있음
- 이때 loss는:
(Eq. 14) $\mathcal{L}_{Flow}=\mathbb{E}_{t,x_{1},z}\left[\left|\left| \hat{u}_{\theta}\left( x_{t},t,\mu,\hat{e}(t)\right)-u\right|\right|^{2}\right]$
- $\hat{u}_{\theta}$ : velocity estimator, $\hat{e}(t)$ : (Eq. 13)
- 추가적으로 Classifier-Free Guidance는 probability $p_{cfg}=0.2$로 conditioning을 randomly dropping 하는 방식으로 적용됨
3. Experiments
- Settings
- Dataset : EmoVoice-DB
- Comparisons : CosyVoice2, WeSCon, EmoVoice, Moss-TTS, Qwen-TTS
- Results
- 전체적으로 EmoTra-TTS의 성능이 가장 뛰어남
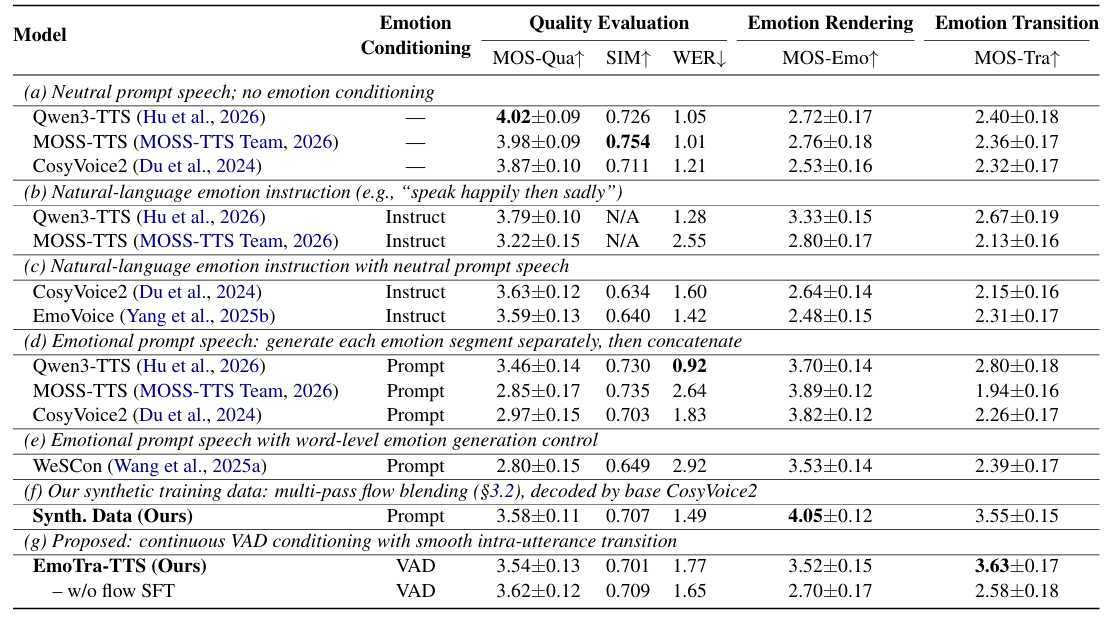
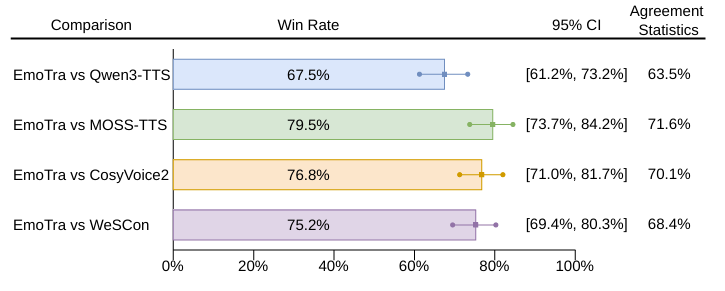
- Pairwise evaluation 측면에서도 EmoTra-TTS가 가장 선호됨
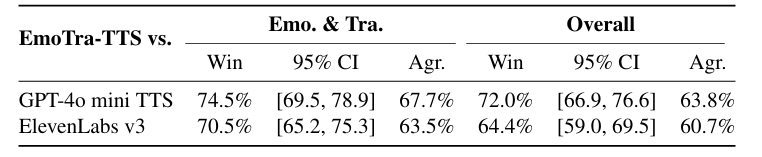
- GPT-4o mini, ElevenLabs와 비교하여도 EmoTra-TTS가 더 선호됨
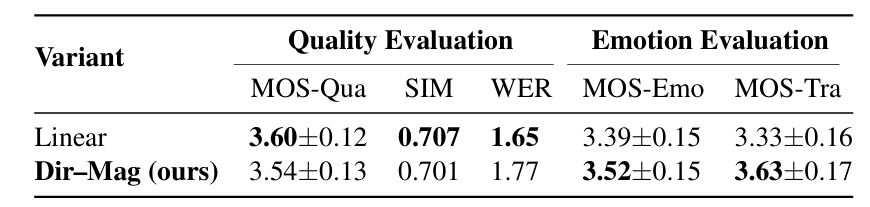
- Injection Architecture
- Simple additive injection은 content preservation에는 효과적이지만 expressiveness 측면에서는 한계가 있음
- 반면 Dir-Mag는 emotion direction을 decouple 하여 뛰어난 emotion performance를 보임
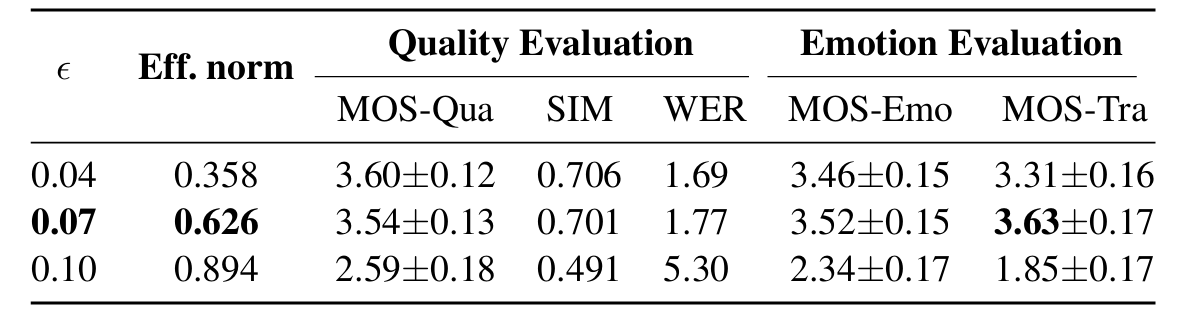
- Ablation Study
- Fixed scale $\epsilon=0.07$을 사용했을 때 최적의 성능을 달성함
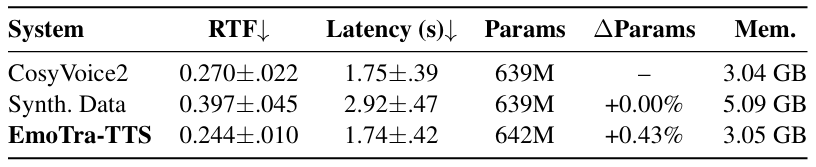
- Inference Latency
- Efficiency 측면에서도 EmoTra-TTS가 가장 뛰어남
반응형
'Paper > TTS' 카테고리의 다른 글
댓글