
티스토리 뷰
Paper/Neural Codec
[Paper 리뷰] BridgeCodec: Mamba Enhanced Neural Audio Codec with Schrodinger Bridge at Low Bitrate
feVeRin 2026. 10. 16.반응형
BridgeCodec: Mamba Enhanced Neural Audio Codec with Schrodinger Bridge at Low Bitrate
- Neural audio codec은 rigidly co-trained encoder-decoder pair로 인해 interoperability의 한계가 있음
- BridgeCodec
- Cross-codec translation을 Schrodinger bridge로 formulate 하여 disparate distribution 간의 robust mapping을 지원
- 추가적으로 Mamba-enhanced U-Net architecture를 활용하여 long range temporal dependency를 capture
- 논문 (INTERSPEECH 2026) : Paper Link
1. Introduction
- Neural Audio Codec (NAC)는 strictly co-trained encoder-decoder pair에 의존적임
- 해당 coupling으로 인해 heterogeneous network 간 interoperability gap이 발생함
- 즉, asymmetric hardware에서 codec이 independently deploy 된 경우 서로 communication 할 수 없음
-> 그래서 frozen, mismatched endpoint에서도 동작가능한 NAC인 BridgeCodec을 제안
- BridgeCodec
- Latent transportation을 Schrodinger Bridge optimal transport problem으로 formulate 하여 encoder-decoder를 decouple
- 추가적으로 Mamba를 U-Net backbone에 integrate 하여 linear complexity로 global dynamics를 capture
< Overall of BridgeCodec >
- Schrodinger Bridge formulation과 Mamba architecture를 활용한 neural codec
- 결과적으로 기존보다 우수한 성능을 달성
2. Method
- Overall Architecture
- NAC는 channel dimension $D_{c}$, frame length $T_{H}$에 대해, audio waveform $X\in\mathbb{R}^{T_{X}}$를 encoder $\text{En}(\cdot)$을 통해 latent representation $H\in\mathbb{R}^{D_{c}\times T_{H}}$로 compress 함
- 이후 $L$ vector quantization (VQ) layer를 가지는 quantizer를 통해 $H$를 discrete token $Q\in\mathbb{R}^{L\times T_{H}}$로 mapping 함
- Token에 해당하는 embedding은 모든 $L$ layer에서 summation 되어 quantized continuous feature $H_{q}\in\mathbb{R}^{D_{c}\times T_{H}}$를 reconstruct 함
- 최종적으로는 decoder $\text{De}(\cdot)$를 사용해 $H_{q}$로부터 audio $X_{q}$를 reconstruct 함
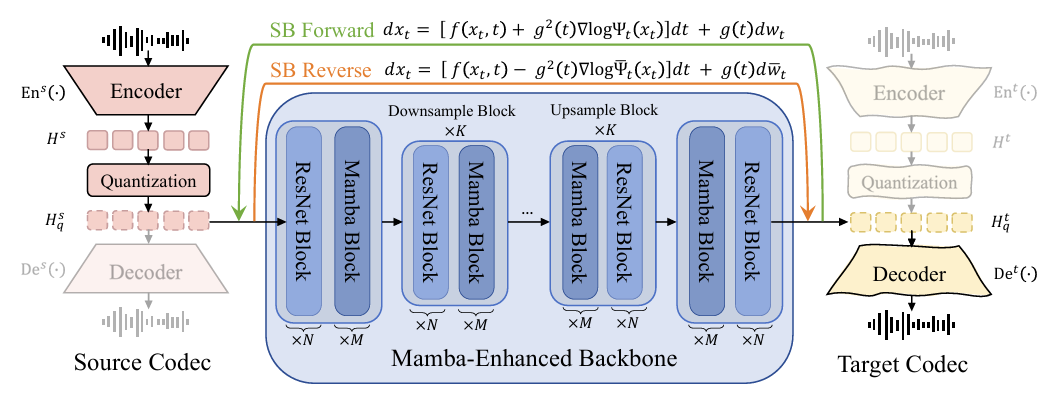
- 특히 논문은 source encoder $\text{En}^{s}(\cdot)$, target encoder $\text{De}^{t}(\cdot)$을 fundamentally decouple 하여 heterogeneous codec 간의 interoperability를 달성하는 것을 목표로 함
- 이를 위해 Schrodinger Bridge (SB)를 사용하여 intermediary latent translator를 formulate 하고 Mamba-enhanced backbone을 활용해 source latent feature $H^{s}_{q}$를 target latent feature $H_{q}^{t}$로 direct translate 함
- 해당 transformation은 latent space에서 operate 하므로 source/target codec은 서로 다른 architecture를 가질 수 있음
- 이후 $L$ vector quantization (VQ) layer를 가지는 quantizer를 통해 $H$를 discrete token $Q\in\mathbb{R}^{L\times T_{H}}$로 mapping 함
- Schrodinger Bridges
- BridgeCodec을 구성하기 위해서는 source latent $H_{q}^{s}$와 target latent $H_{q}^{t}$ 간의 direct mapping을 establish 해야 함
- 이때 standard diffusion은 terminal distribution을 Gaussian noise prior $p_{T}=\mathcal{N}(0,I)$로 constrain 하여 $H_{q}^{s}$의 preserved speech prior를 destructively overwrite 하므로 mathematically ill-suite 함
- 따라서 논문은 latent translation을 Schrodinger Bridge (SB) optimal transport problem으로 formulate 함 - SB는 pre-defined noise prior 없이 arbitrary distribution 간의 transition을 학습할 수 있으므로 structurally mismatched compressed latent space를 robustly bridge 할 수 있음
- SB는 reference path $p_{ref}$에 대한 Kullback-Leibler divergence를 minimize 하면서 boundary constraint $p_{0}=p_{target}$, $p_{T}=p_{source}$를 만족하는 optimal path measure $p\in\mathcal{P}_{[0,T]}$를 find 함:
(Eq. 1) $\min_{p\in\mathcal{P}_{[0,T]}}D_{KL}(p||p_{ref})\,\,\,\text{s.t.}\,\,p_{0}=p_{target},p_{T}=p_{source}$
- $p_{source}, p_{target}$ : connect 할 두 distribution - (Eq. 1)에 대한 path measure solution은 forward-backward Stochastic Differential Equation (SDE) pair로 얻어짐:
(Eq. 2) $dx_{t}=\left[f(x_{t},t)+g^{2}(t)\nabla\log \Psi_{t}(x_{t})\right]dt+g(t)dw_{t}$
(Eq. 3) $dx_{t}=\left[f(x_{t},t)-g^{2}(t)\nabla\log\bar{\Psi}_{t}(x_{t})\right]dt+g(t)d\bar{w}_{t}$
- $f(x_{t},t), g(t)$ : reference SDE에서 정의된 $p_{ref}$에서 inherit 됨, $dw_{t}, d\bar{w}_{t}$ : distinct Wiener process - Forward, backward evolution은 각각 distinct non-linear drift term $+g^{2}(t)\nabla\log\Psi_{t}(x_{t})$와 $-g^{2}\nabla\log \bar{\Psi}_{t}(x_{t})$로 characterize 됨
- $x_{t}$의 marginal distribution은 $t\in[0,T]$에 대해 $p_{t}=\Psi_{t}\bar{\Psi}_{t}$와 같음
- SB는 reference path $p_{ref}$에 대한 Kullback-Leibler divergence를 minimize 하면서 boundary constraint $p_{0}=p_{target}$, $p_{T}=p_{source}$를 만족하는 optimal path measure $p\in\mathcal{P}_{[0,T]}$를 find 함:
- SB는 linear drift $f(x_{t})=f(t)x_{t}$와 Gaussian boundary 하에서 tractable closed-form solution을 가짐
- $p_{0}=\mathcal{N}(x_{0},\epsilon_{0}^{2}I)$, $p_{T}=\mathcal{N}(x_{T},\epsilon_{T}^{2}I)$, $\epsilon_{T}=e^{\int_{0}^{T}f(\tau)d\tau}\epsilon_{0}$라고 하자
- $\epsilon_{0}\rightarrow 0$일 때 forward/backward term $\Psi_{t},\bar{\Psi}_{t}$는 $\bar{\Psi}_{t}\mathcal{N}(\alpha_{t}x_{0},\alpha^{2}_{t}\sigma_{t}^{2}I)$, $\Psi_{t}\mathcal{N}(\bar{\alpha}_{t}x_{T},\alpha^{2}_{t}\bar{\sigma}_{t}^{2}I)$와 같음
- $\alpha_{t}=e^{\int_{0}^{t}f(\tau)d\tau}$, $\sigma^{2}_{t}=\int_{0}^{t}g^{2}(\tau)/\alpha_{\tau}^{2}d\tau$, $\bar{\alpha}_{t}=\alpha_{t}\alpha_{T}^{-1}$, $\bar{\sigma}_{t}^{2}=\sigma^{2}_{T}-\sigma^{2}_{t}$ - 결과적으로 marginal $p_{t}=\Psi_{t}\bar{\Psi}_{t}$는:
(Eq. 4) $p_{t}=\mathcal{N}\left(w_{0}(t)x_{0}+w_{T}(t)x_{T}, \alpha^{2}_{t}\sigma^{2}_{t}\bar{\sigma}^{2}_{t}/\sigma^{2}_{T}I\right)$
- $w_{0}(t)=\alpha_{t}\bar{\sigma}_{t}^{2}/\sigma_{T}^{2}$, $W_{T}(t)=\bar{\alpha}_{t}\sigma^{2}_{t}/\sigma^{2}_{T}$ : time varying weight
- 논문에서 terminal distribution mean $x_{T}$와 initial distribution mean $x_{0}$는 각각 source codec feature $H_{q}^{s}$, target codec feature $H_{q}^{t}$에 해당함
- Optimization은 sampled $x_{t}\sim p_{t}$에서 $x_{0}$를 predict 하는 bridge loss를 사용함:
(Eq. 5) $\mathcal{L}_{bridge}=\mathbb{E}_{x_{T}\sim p_{T},x_{0}\sim p_{0}}\mathbb{E}\left[ \left|\left| x_{\theta}(x_{t},t,x_{T})-x_{0}\right|\right|_{2}^{2}\right]$
- $x_{\theta}(\cdot)$ : parameterized prediction model
- 이때 standard diffusion은 terminal distribution을 Gaussian noise prior $p_{T}=\mathcal{N}(0,I)$로 constrain 하여 $H_{q}^{s}$의 preserved speech prior를 destructively overwrite 하므로 mathematically ill-suite 함
- Mamba-Enhanced Backbone
- Standard U-Net은 acoustic latent에서 localized structual pattern을 추출할 수 있지만, prosodic fluctuation, phonetic coherence 같은 long-range temporal correlation을 capture 하는 데는 한계가 있음
- 따라서 논문은 Mamba를 latent translation backbone에 incorporate 함
- 구조적으로는 U-Net의 $K$ resolution level에 Mamba module을 interleave 함
- 각 encoder downsampling stage에서 input latent $H_{q}^{s}\in\mathbb{R}^{B\times 1\times D_{c}\times T_{H}}$는 $N$ convolutional residual block으로 process 됨
- 이후 local feature extraction은 representation을 intermediate tensor $H_{conv}\in\mathbb{R}^{B\times C\times D_{r}\times T_{H}}$로 expand 함
- $C$ : channel dimension, $D_{r}$ : hidden dimension - $H_{conv}$는 spatial dimension으로 flatten 되어 $\mathbb{R}^{B\times T_{H}\times D_{m}}$의 sequence를 생성하고 $M$ consecutive Mamba layer를 route하여 global temporal context를 생성함
- $D_{m}=C\times D_{r}$ - 해당 globally-enriched output은 original topology $\mathbb{R}^{B\times C\times D_{r}\times T_{H}}$로 reshape 됨
- Decoder는 해당 Mamba-enhanced hierarchy를 mirror 하여 Schrodinger Bridge transport path에 대한 synchronized local-global feature alignment를 보장함
- Two-Stage Training Strategy
- SB objective $\mathcal{L}_{bridge}$를 optimize 하면 latent space에서 strict optimal transport를 보장할 수 있지만, sub-optimal perceptual quality를 가질 수 있음
- 따라서 논문은 2-stage training을 도입해 latent structral accuracy와 audio-domain fidelity를 align 함
- First stage에서는 (Eq. 5)를 사용해 SB model을 highly compressed latent domain에서 exclusively train 하여 heterogeneous codec 간의 robust transport path를 establish 함
- Second stage에서는 pre-trained SB translator를 frozen target decoder $\text{De}^{t}(\cdot)$과 cascade 하여 time-domain waveform $\hat{X}$를 reconstruct 함
- 이후 translator는 ground-truth wideband audio $X$에 대해 joint objective로 fine-tuning 됨:
(Eq. 6) $\mathcal{L}_{total}=\lambda_{bridge}\mathcal{L}_{bridge}+\lambda_{t}\mathcal{L}_{time}+\lambda_{mel}\mathcal{L}_{mel}$
- $\mathcal{L}_{time} = ||X-\hat{X}||_{1}$ : time-domain $L1$ loss
- $\mathcal{L}_{mel} = ||S(X)-S(\hat{X})||_{1}$ : frequency-domain spectrogram $L1$ loss
- $S(\cdot)$ : spectrogram function, $\lambda_{bridge},\lambda_{t},\lambda_{mel}$ : hyperparameter
3. Experiments
- Settings
- Dataset : DNS Challenge
- Comparisons : 48kHz-6kbps Codec, 8kHz-1kbps Codec
- Results
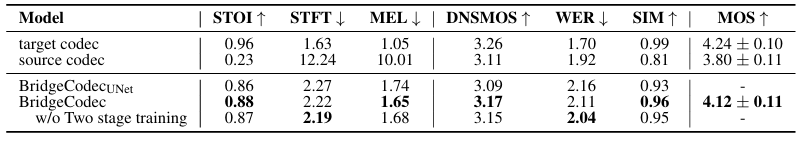
- 전체적으로 BridgeCodec의 성능이 가장 우수함
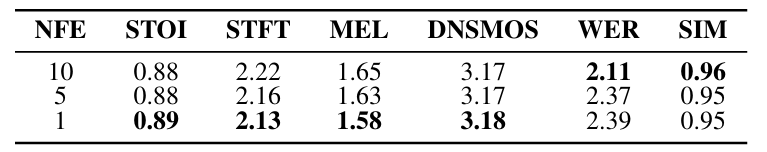
- NFE를 1로 설정하여도 뛰어난 성능을 보임
반응형
'Paper > Neural Codec' 카테고리의 다른 글
댓글